
Servidor para machine learning ou workstation
O time de dados que era de duas pessoas virou cinco em um ano. A GPU que atendia bem virou fila: alguém deixa um fine-tuning rodando na sexta à noite, outro precisa validar um modelo antes da reunião de segunda e espera. Em paralelo, a conta de nuvem que nasceu como experimento virou linha fixa […]
GPU para data science: qual placa escolher em 2026
Você deixa o Jupyter processando um groupby sobre um arquivo de 8 GB, sai para almoçar e volta com a célula ainda ocupada. A busca de hiperparâmetros do XGBoost entrou pela madrugada e, a cada feature nova, tudo recomeça. A conclusão parece óbvia: falta placa de vídeo. É por aí que começa a pesquisa por […]
Workstation para Inteligência Artificial: Guia 2026
Você roda a célula que carrega o modelo e recebe CUDA out of memory. Reduz o batch size, roda de novo, mesma mensagem. Reduz o contexto, quantiza para 4 bits, e finalmente o modelo entra na placa, só que agora responde devagar e com qualidade pior. Duas horas depois você desiste e sobe tudo para […]
Quanta VRAM para rodar LLM local: guia e tabela
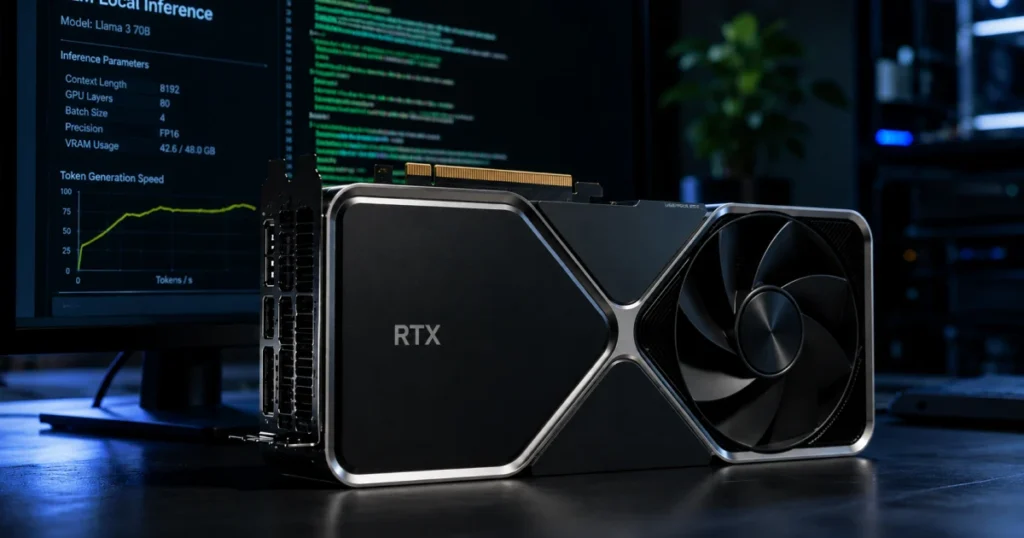
Você baixa um modelo de 70 bilhões de parâmetros, manda carregar e recebe CUDA out of memory em três segundos. Troca por uma versão quantizada, o modelo entra, e a geração sai a dois tokens por segundo, mais devagar do que você lê. Aumenta o contexto para processar um contrato inteiro e o erro de […]
CPU ou GPU para Machine Learning: onde alocar a verba
Existe um jeito clássico de gastar mal o dinheiro de um projeto de IA: colocar quase tudo na placa de vídeo mais forte que o orçamento aguenta, montar o resto da máquina com o que sobrou e descobrir três semanas depois que a época de treino demora quase o mesmo tempo. A GPU nova está […]