
Workstation para renderização: guia completo
São sete da noite, o cliente aprovou a mudança na fachada e a apresentação é às nove da manhã. Você joga seis câmeras na fila, fecha o escritório e volta no dia seguinte com quatro imagens prontas, uma cheia de ruído e uma que parou no meio por falta de memória. Não sobra tempo para […]
GPU para data science: qual placa escolher em 2026
Você deixa o Jupyter processando um groupby sobre um arquivo de 8 GB, sai para almoçar e volta com a célula ainda ocupada. A busca de hiperparâmetros do XGBoost entrou pela madrugada e, a cada feature nova, tudo recomeça. A conclusão parece óbvia: falta placa de vídeo. É por aí que começa a pesquisa por […]
GPU para inferência de IA: como dimensionar
A fatura da API chegou maior que a do mês passado outra vez, e ninguém consegue prever a do mês que vem. Ou aconteceu o oposto: a empresa comprou máquina cara para treinar modelo, colocou o serviço em produção nela e descobriu que, com doze pessoas perguntando ao mesmo tempo, a resposta trava. Os dois […]
Placa de vídeo para workstation: guia 2026
Existe um roteiro que se repete quase toda semana no atendimento técnico. O profissional troca a placa de vídeo, liga a máquina, abre a cena de sempre e o problema continua exatamente onde estava. Às vezes piora, porque a placa nova puxa mais energia do que a fonte antiga entrega com folga. Quem escolheu comparou […]
Workstation para Inteligência Artificial: Guia 2026
Você roda a célula que carrega o modelo e recebe CUDA out of memory. Reduz o batch size, roda de novo, mesma mensagem. Reduz o contexto, quantiza para 4 bits, e finalmente o modelo entra na placa, só que agora responde devagar e com qualidade pior. Duas horas depois você desiste e sobe tudo para […]
Quanta VRAM para rodar LLM local: guia e tabela
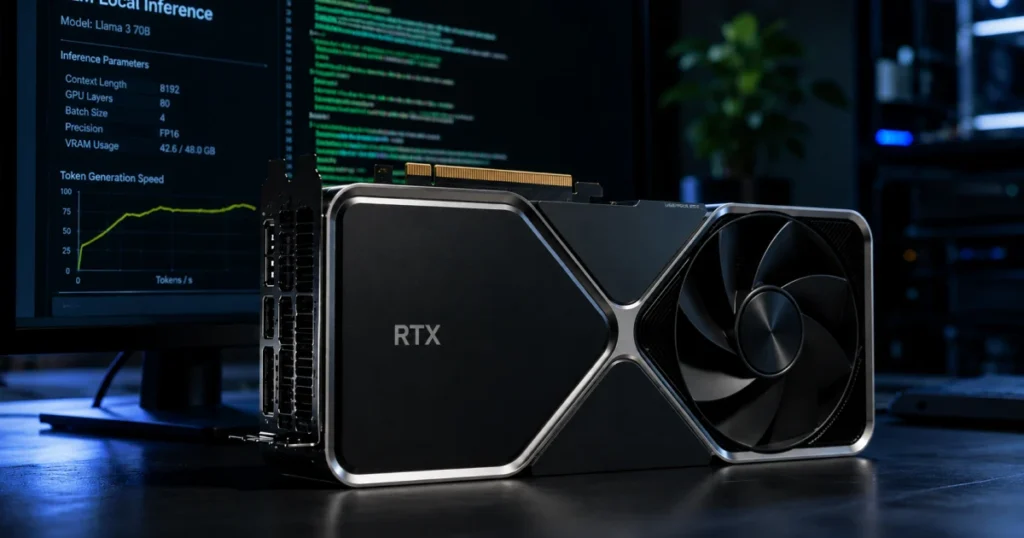
Você baixa um modelo de 70 bilhões de parâmetros, manda carregar e recebe CUDA out of memory em três segundos. Troca por uma versão quantizada, o modelo entra, e a geração sai a dois tokens por segundo, mais devagar do que você lê. Aumenta o contexto para processar um contrato inteiro e o erro de […]